别盲目下载20G模型了,llmfit一条命令告诉你的硬件能跑哪些 llmfit 1.1.16
llmfit 是开源免费的终端工具,自动检测你的 CPU/RAM/GPU/VRAM,告诉你哪些开源大模型能流畅运行,支持量化档位推荐和速度估算。
大小
未知
下载
0
次
语言
中英
中英
兼容性
macOS
macOS
版本类型
1.1.16
资源版本
适用平台
macOS / Linux / Windows
支持系统
网盘资源 3
- 夸克网盘 夸克网盘 前往下载 复制下载信息
- 官网地址 官网地址 前往下载 复制下载信息
- GitHub 仓库 GitHub 仓库 前往下载 复制下载信息
资源介绍/功能
玩本地大模型最头疼的是什么?不是你的显卡不行,而是你根本不知道该下哪个模型。Llama 3 8B?Qwen 2.5 72B?DeepSeek-V3?下下来发现显存不够,白折腾一趟。最近开源社区有个叫 llmfit 的工具火了,37k stars,做的事情很简单:一条命令告诉你的硬件能跑哪些模型。

它到底做了什么
llmfit 是一个 Rust 写的终端工具,核心功能就是硬件检测 + 模型匹配。它会自动读取你机器的 CPU 核心数、内存大小、GPU 型号和显存容量,然后对照内置的模型数据库,逐个计算每个模型在不同量化档位下的内存占用,告诉你哪些能跑、哪些跑不动、哪些跑起来会卡。
支持检测的硬件架构很全:NVIDIA CUDA、Apple Silicon(M 系列芯片的统一内存)、AMD ROCm、Intel OneAPI 都能识别。模型方面覆盖了 GGUF、AWQ、GPTQ、EXL2 等主流量化格式,从几 B 的小模型到几十上百 B 的大模型都有。

安装与使用(Windows / macOS 命令完全一致)
⚠️ 版本 v1.1.16,参数不分平台,Windows CMD/PowerShell 和 Mac 终端命令行语法相同。 Windows 解压版:需要 cd 到 exe 目录或把 exe 拖入终端执行;Mac 安装 brew 版本后直接全局调用。
安装方式
Windows:
# Scoop 安装(全局调用)
scoop install llmfit

# 手动二进制包:解压后,在文件夹地址栏输入 cmd 打开终端,直接运行
llmfit --version
macOS:
# Homebrew 安装
brew install llmfit
常用命令速查
1. 交互式 TUI(最常用,可视化界面):
llmfit
TUI 界面内快捷键:
j/ ↓ 下移,k/ ↑ 上移/搜索模型名称f打开筛选(完美/可运行/全部)s切换排序(适配分数、速度、质量)pPlan 模式:反向估算某个模型需要多少显存内存d下载模型(联动 Ollama)q退出
2. 查看本机硬件信息:
# 查看硬件信息(CPU/内存/显存)
llmfit system

# JSON 格式输出(脚本读取)
llmfit system --json

# 硬件诊断,排查显卡识别异常
llmfit doctor
3. 模型推荐(最常用):
# 自动推荐适合本机的模型
llmfit recommend

# JSON 输出推荐列表
llmfit recommend --json

# 只推荐聊天对话模型,限制返回 8 条
llmfit recommend --use-case chat --limit 8

# 只推荐代码模型
llmfit recommend --use-case coding --limit 5

# 只推荐【完美适配】的聊天模型
llmfit recommend --use-case chat --perfect --limit 5

4. 模型列表筛选:
# 按适配分数排序,列出全部模型
llmfit fit

# 只列出完美适配,前 5 条
llmfit fit --perfect -n 5
5. 查询单个模型详情:
# 查看指定模型详细评估,示例 Qwen2.5 14B
llmfit info "Qwen/Qwen2.5-14B-Instruct"
6. 反向硬件规划(已知模型,算需要多少内存):
# 估算运行该模型,上下文 8192 需要多少硬件
llmfit plan "Qwen/Qwen2.5-14B-Instruct" --context 8192
7. 搜索模型:
llmfit search "qwen2.5"
llmfit search "llama 70b"
8. 保存输出到文件:
# Windows
llmfit recommend --json --use-case chat > chat_models.json
# Mac
llmfit recommend --json --use-case chat > chat_models.json
硬件模拟:换台电脑不行,那就模拟一台
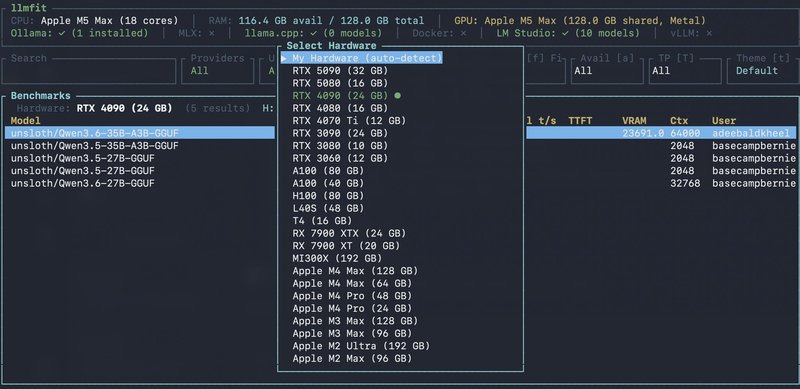
llmfit 有个挺有意思的功能叫硬件模拟(Simulation)。你不用真的换显卡,直接在 TUI 里按 s 打开模拟器,可以手动修改虚拟的 RAM、VRAM、GPU 型号,llmfit 会重新计算所有模型的适配度。
这个功能对做部署规划的人特别实用。比如你想提前知道"如果客户用的是 RTX 4060 + 32G 内存,哪些模型能跑",不用真去买机器,模拟一下就行。
基准测试与社区共享
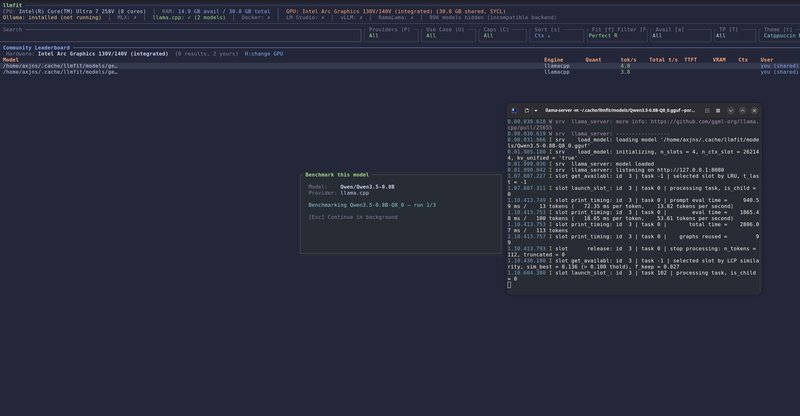
llmfit 不只是个"看"的工具,它还能"测"。内置的基准测试功能可以对你实际跑的模型测量真实的 token 速度(tok/s)和首 token 延迟(TTFT)。测完还能一键 llmfit bench --share 把结果提交回社区。
这个设计挺聪明的:每个人的硬件配置不一样,官方给的估算数据再准也有偏差。社区共享让同一配置的用户能直接看到别人的实测数据,llmfit info 命令会优先显示你自己机器上的实测结果,其次才是估算值。
适合谁用
llmfit 适合这几类人:一是折腾本地大模型的玩家,不想每次下模型都赌运气;二是做 AI 部署的工程师,需要快速评估目标硬件能跑哪些模型;三是有多台不同配置机器的用户,想在上部署前先确认可行性。
如果你已经有 Ollama、llama.cpp 或 LM Studio 这些本地推理框架,llmfit 还能直接对接,不仅能看模型适配度,还能一键下载到对应的推理引擎里。项目 MIT 协议开源,macOS / Linux / Windows 全平台支持,装一条命令的事,值得试试。
配置要求
| 配置项 | 最低配置 |
|---|---|
| 操作系统 | macOS / Linux / Windows |
| 其他要求 | 需要支持 WebGPU 的浏览器(仅 Web UI 模式) |
安装说明:Homebrew / Scoop / curl / cargo 等多种方式安装